Índice do artigofaltam 18 min de leitura
Os agentes de IA já conseguem abrir aplicativos, ler e-mails, consultar documentos, preencher formulários e tomar algumas decisões. O problema é que fazer partes de um processo não é o mesmo que entregar o processo inteiro.
O OSWorld 2.0, nome também divulgado como OSWorld 2, foi criado para medir essa diferença. Em vez de pedir uma ação curta, o benchmark reúne fluxos profissionais que atravessam aplicações, arquivos, mensagens, regras e decisões ao longo de centenas de passos.
A principal conclusão não é que os agentes “falham em 79,4% de tudo”, como sugeria a leitura apressada dos 20,6% do paper de lançamento, nem que falham em 55,7%, como sugeriria a do topo do ranking de outubro. É que a distância entre progresso parcial e conclusão confiável ainda é grande, e essa distância precisa orientar arquitetura, custo, segurança e supervisão humana.
Resumo do artigo
- O OSWorld 2 reúne 108 tarefas profissionais longas: a mediana exige cerca de 1,6 hora de trabalho humano e os agentes executam, em média, 318 ações por tentativa.
- No lançamento, o melhor resultado do paper combinava 54,8% de pontuação parcial com 20,6% de conclusão binária. No leaderboard atualizado em 15/10/2026, o topo da categoria de modelo sozinho, no conjunto completo, passou a 77,67% e 44,33% (Claude Opus 5, esforço max, versão 2.1), e a distância entre as duas colunas continua grande.
- A Anthropic reporta 70,57% de Pass@1 para o Claude Opus 5 em protocolo próprio; a própria Anthropic publicou depois números para Claude Fable 5.1, Opus 5.5 e Fable 5.2, quase todos em pontuação parcial (só a página do Fable 5.1 traz também a métrica estrita, com 41,7% para ele), e nenhum dos três tinha entrada no ranking oficial até 11/11/2026.
- Na faixa de tarefas mais longas, entre 163 e 360 minutos, todos os modelos exibidos no paper ficaram em 0% de conclusão binária.
Resumo executivo
| Indicador | O que o número realmente significa |
|---|---|
| 108 tarefas | Conjunto do OSWorld 2 com fluxos profissionais longos e realistas. |
| 1,6 hora | Duração mediana para uma pessoa qualificada concluir uma tarefa. |
| 318 ações | Média de chamadas de ferramenta dos agentes avaliados, contra aproximadamente 30 no OSWorld original. |
| 20,6% | Melhor conclusão binária do paper de lançamento: Claude Opus 4.8, em configuração max e execução em lote, na primeira versão das tarefas. |
| 54,8% | Pontuação parcial da mesma configuração: houve bastante progresso, mas nem sempre entrega completa. |
| 44,33% | Melhor conclusão binária de modelo sozinho, no conjunto completo, no leaderboard oficial atualizado em 15/10/2026: Claude Opus 5, esforço max, versão 2.1 das tarefas, com 77,67% de pontuação parcial. |
| 70,57% | Pass@1 reportado pela Anthropic para Claude Opus 5, em protocolo próprio descrito no System Card. |
| 89,3% | Pontuação parcial que a Anthropic reporta para o Claude Fable 5.2 no subconjunto offline da versão 2.1, em 9/11/2026. Número do fabricante, sem entrada no ranking oficial. |
Esses números respondem a perguntas diferentes. Misturá-los em um único ranking cria uma conclusão atraente, mas metodologicamente incorreta.
O que é o OSWorld 2.0
O OSWorld 2 avalia agentes que controlam um computador em ambientes com navegador, e-mail, planilhas, documentos, sistemas empresariais, arquivos e aplicações multimídia. O paper oficial descreve três princípios centrais:
- fluxos autênticos: as tarefas são inspiradas em trabalho profissional real;
- horizonte longo: o agente precisa sustentar contexto, estado e restrições por centenas de ações;
- avaliação verificável: cada tarefa possui checkpoints objetivos que permitem medir tanto o resultado final quanto o progresso intermediário.
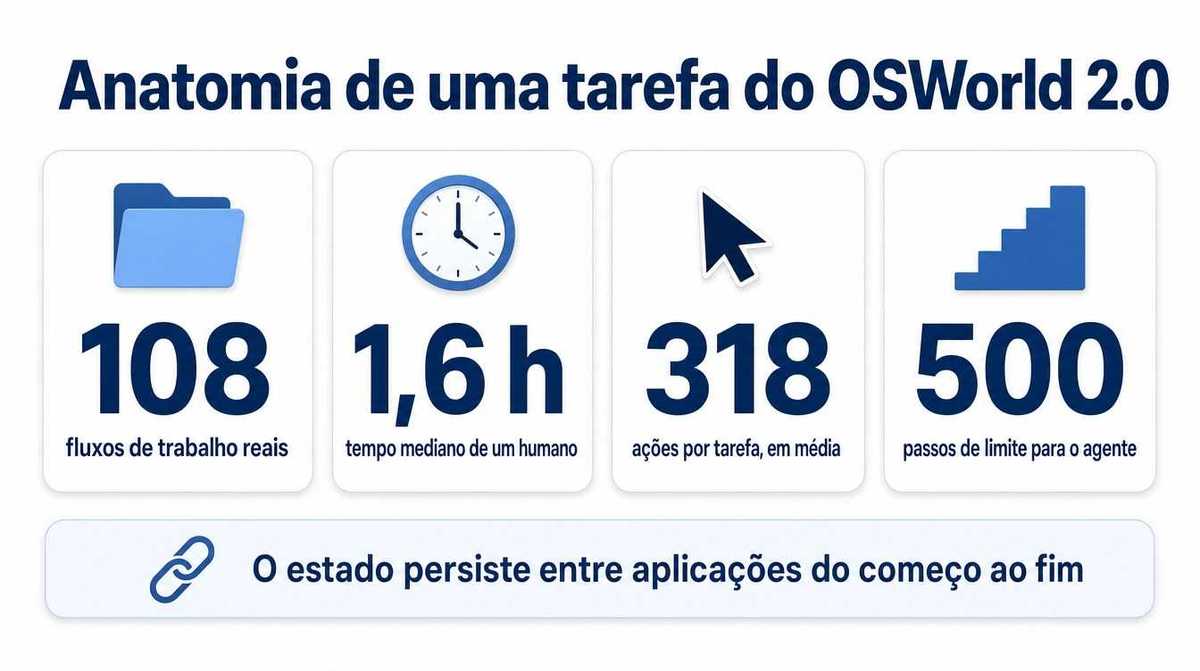
Quase 70% das tarefas exigem mais de uma hora de trabalho humano. Os agentes usam, em média, 318 chamadas de ferramenta, e o protocolo principal permite até 500 passos. Isso muda a natureza do teste: o desafio deixa de ser “encontrar o botão certo” e passa a ser “preservar a intenção do usuário durante um processo inteiro”.
OSWorld, OSWorld-Verified e OSWorld 2.0: não confunda
Os três nomes pertencem à mesma família, mas não representam a mesma dificuldade.
| Benchmark | Foco | Horizonte típico | Como interpretar |
|---|---|---|---|
| OSWorld | Uso geral de aplicações reais em diferentes sistemas operacionais. | Tarefas relativamente curtas, com cerca de 30 ações dos agentes no comparativo apresentado pelo novo paper. | Mede capacidade de percepção e operação em interfaces. |
| OSWorld-Verified | Versão revisada do conjunto anterior para reduzir tarefas e avaliações problemáticas. | Ações mais curtas e autocontidas, raramente atravessando mais de uma ou duas aplicações. | É melhor para comparar competência em tarefas delimitadas. |
| OSWorld 2 | Fluxos profissionais conectados, com múltiplas fontes, aplicações, mudanças de estado e decisões. | Mediana humana de 1,6 hora e média de 318 ações dos agentes. | Mede resistência a erros acumulados e capacidade de finalizar trabalho de ponta a ponta. |
O próprio paper usa um contraste importante: Claude Opus 4.8 chega a 83,5% no OSWorld-Verified, mas a 20,6% de conclusão binária no OSWorld 2. Não há contradição. A segunda avaliação mede um horizonte muito mais longo, no qual pequenos desvios se acumulam.
Como ler conclusão binária, progresso parcial e Pass@1
Conclusão binária
A métrica binária responde à pergunta mais exigente: o agente concluiu todo o trabalho?
Se uma prestação de contas exige cinco despesas corretas, anexos, centro de custo, aprovação e envio final, deixar uma etapa crítica errada resulta em zero na conclusão binária, mesmo que boa parte do processo tenha sido feita.
Essa é a métrica mais próxima de uma entrega empresarial utilizável, embora ainda não inclua todos os riscos de produção.
Pontuação parcial
O OSWorld 2 divide cada tarefa em checkpoints objetivos, em média 27,25 checkpoints por tarefa. A pontuação parcial mede quantos desses requisitos foram cumpridos.
Pontuação parcial alta mostra que o agente avançou e pode ter economizado trabalho. Ela não autoriza dizer que o processo foi concluído. Em produção, esse progresso pode ser útil quando um humano revisa e finaliza; pode ser perigoso quando a automação publica, paga, apaga ou envia algo sem validação.
Pass@1
Pass@1 normalmente representa a chance de sucesso em uma tentativa, sob um protocolo específico. No System Card do Claude Opus 5, a Anthropic descreve o resultado como taxa de sucesso na primeira tentativa, calculada como média de cinco execuções.
O nome da métrica, o ambiente, a resolução, o limite de passos, o avaliador e o sistema que cerca o modelo precisam acompanhar o número. Por isso, 70,57% de Pass@1 não deve ser renomeado como 70,57% de pontuação parcial e também não deve ser colocado na mesma coluna dos 20,6% binários sem uma reprodução comparável.
Resultados oficiais do paper e do leaderboard
Esta é a comparação publicada para as três melhores configurações em lote do paper, na primeira versão das tarefas (v2026.06.24). O custo representa a média aproximada por tarefa avaliada, não o custo de uma conclusão garantida.
| Modelo e configuração | Conclusão binária | Pontuação parcial | Custo médio por tarefa |
|---|---|---|---|
Claude Opus 4.8, max, em lote | 20,6% | 54,8% | US$ 72,40 |
Claude Opus 4.7, max, em lote | 18,2% | 48,91% | US$ 33,60 |
GPT-5.5, xhigh, em lote | 13,0% | 49,5% | US$ 25,50 |
Fonte: paper do OSWorld 2 e leaderboard mantido pelo projeto. A linha destacada é a melhor conclusão binária publicada no paper.
O valor mais útil é a diferença entre as duas colunas de desempenho. No Opus 4.8, por exemplo, 54,8% de progresso parcial coexistem com 20,6% de conclusão integral. O modelo frequentemente faz partes corretas, mas ainda perde detalhes, deixa requisitos para trás ou não verifica o estado final.
O que mudou no leaderboard até outubro de 2026
Depois do paper, os autores publicaram duas novas versões das tarefas: a de 8 de agosto de 2026, com código, arquivos e sites simulados atualizados, e a 2.1, de 16 de setembro, descrita no repositório oficial como correção de bugs com agentes e fluxos de avaliação atualizados. O leaderboard passou a mostrar a versão de cada linha e um subconjunto offline de 82 tarefas que rodam sem internet.
Na leitura de 11/11/2026 (dados com última atualização em 15/10/2026), estas são as principais linhas com esforço max de cada versão das tarefas na categoria principal, com o modelo operando sozinho, 500 passos e conjunto completo de 108 tarefas:
| Modelo, esforço e versão das tarefas | Conclusão binária | Pontuação parcial |
|---|---|---|
Claude Opus 5, max, versão 2.1 | 44,33% | 77,67% |
MuseSpark 1.3 (Meta), max, versão 2.1 | 39,25% | 69,56% |
Claude Opus 5, max, versão de agosto | 31,43% | 68,31% |
GPT-5.6 Sol, max, versão de agosto | 27,34% | 62,72% |
Claude Opus 4.8, max, versão de junho (paper) | 20,6% | 54,8% |
Fonte: leaderboard oficial do OSWorld 2, lido em 11/11/2026. Na versão de agosto, o projeto informa média de 7 execuções para o Claude Opus 5 e de 2 para o GPT-5.6 Sol. Linhas de versões diferentes usam arquivos de tarefa diferentes e não formam um ranking único. O leaderboard também traz o Claude Opus 5 em outros níveis de esforço; na versão 2.1, o nível high marca 36,89% de conclusão binária, acima dos 33,33% do xhigh, embora fique abaixo dele na parcial (68,92% contra 73,11%); mais esforço não garante mais tarefas concluídas. A linha do MuseSpark 1.3 vem marcada como conjunto completo, mas a trajetória publicada pelo projeto cobre 106 tarefas.
Dois pontos merecem atenção. Primeiro, a conclusão binária mais que dobrou desde o paper, mas parte do ganho vem de tarefas corrigidas, não só de modelos melhores; por isso o próprio leaderboard separa as versões. Segundo, mesmo no topo, mais da metade das tarefas ainda termina sem entrega completa, e a distância entre parcial e binária continua acima de 30 pontos.
Na aba que inclui sistemas de agente, uma combinação de framework com o Claude Opus 4.8 (Darwinx, da Salesforce AI Research, limite de 450 passos) aparece com 44,44% de conclusão binária e 75,97% de pontuação parcial na versão 2.1. A própria linha registra duas diferenças: a tarefa conta como concluída a partir de 99% dos checkpoints, e não pelo critério estrito da categoria principal, e o raciocínio estendido do modelo ficou desligado. Por isso esse número não se compara diretamente com os 44,33% do Claude Opus 5 sozinho. O que ele mostra é que um framework bem desenhado consegue tirar de um modelo da geração anterior um resultado na mesma faixa, ou seja, o sistema em volta do modelo também pesa no resultado.
Atualização: como interpretar os 70,57% do Claude Opus 5
A página de lançamento do Claude Opus 5 afirma que o modelo supera os demais no OSWorld 2 considerando desempenho e custo. O documento técnico oferece o contexto necessário para interpretar a afirmação.
No System Card do Claude Opus 5, a Anthropic informa:
- execução nas configurações padrão dos modelos;
- resolução de 1080p;
- limite de 500 ações por tarefa;
- uso de Claude Opus 4.8 como avaliador por modelo quando necessário;
- resultado agregado em cinco execuções;
- métrica apresentada como Pass@1 accuracy e taxa de sucesso na primeira tentativa.
| Modelo no gráfico da Anthropic | Pass@1 reportado |
|---|---|
| Claude Opus 5 | 70,6% (70,57% no texto técnico) |
| Claude Fable 5 | 66,1% |
| GPT-5.6 Sol | 62,6% |
| Claude Opus 4.8 | 55,7% |
| Claude Sonnet 5 | 51,4% |
| Muse Spark 1.1 | 47,3% |
O resultado é relevante e indica avanço. Mas há três limites editoriais importantes:
- o gráfico é uma avaliação publicada pela própria Anthropic, não uma entrada do leaderboard independente mantido pelos autores do OSWorld 2;
- a métrica está identificada como Pass@1, não como pontuação parcial;
- quando esta seção foi escrita, em agosto de 2026, o Opus 5 ainda não aparecia no ranking público oficial. Ele entrou depois: no leaderboard atualizado em 15/10/2026, seu melhor resultado no conjunto completo é 44,33% de conclusão binária e 77,67% de pontuação parcial (esforço
max, versão 2.1).
Portanto, a formulação responsável é: a Anthropic reporta 70,57% de Pass@1 para o Claude Opus 5 em seu protocolo do OSWorld 2. A formulação “o Opus 5 conclui sete de cada dez tarefas do ranking oficial” vai além da evidência disponível, e a medição independente confirmou isso: no ranking dos autores, o modelo conclui por inteiro menos da metade das tarefas.
Atualização de novembro: os números que os fabricantes publicaram depois
Depois do Opus 5, a Anthropic publicou linhas de OSWorld 2 nos anúncios de três modelos novos. Nenhum deles aparecia no leaderboard oficial na leitura de 11/11/2026, e cada tabela usa uma versão diferente do conjunto.
| Publicação da Anthropic | Versão e métrica | Resultados reportados |
|---|---|---|
| Claude Fable 5.1, setembro de 2026 | Versão de agosto, parcial e estrita | Fable 5.1: 77,9% parcial e 41,7% estrita. Opus 5, reexecutado nas mesmas condições: 75,4% e 39,6%. |
| Claude Opus 5.5, 22/09/2026 | Versão 2.1, parcial | Opus 5.5: 81,8%. Fable 5.1: 80,7%. Opus 5: 74,0%. |
| Claude Fable 5.2, 09/11/2026 | Versão 2.1, subconjunto offline, parcial | Fable 5.2: 89,3%. Opus 5.5: 87,2%. Gemini 4 Carbon: 81,5%. GPT-6 Astra: 79,5%. Fable 5.1: 83,5%. |
Todos os valores são reportados pela Anthropic. Segundo as páginas do Fable 5.1 e do Fable 5.2, os modelos lançados nelas (e o Opus 5.5, na tabela do Fable 5.2) foram avaliados com as salvaguardas de produção ligadas. Na página do Fable 5.1, a empresa avisa que os números da versão de agosto não são diretamente comparáveis aos resultados publicados antes.
Três cuidados para ler essa tabela:
- quase tudo é pontuação parcial. Só a página do Fable 5.1 traz a métrica estrita, que é a que mede entrega completa; nela, o melhor modelo da Anthropic fica em 41,7%;
- o mesmo modelo muda de número conforme a versão e o subconjunto. O Fable 5.1 aparece com 77,9%, 80,7% e 83,5% em três publicações diferentes. Compare só linhas da mesma tabela;
- o GPT-6 Astra e o Gemini 4 Carbon aparecem na tabela de um concorrente. A página da Anthropic não detalha como esses dois números foram obtidos, e nenhum deles é leitura do leaderboard oficial.
Na régua independente, o melhor resultado foi de 54,8% de pontuação parcial e 20,6% de conclusão binária no paper para 77,67% e 44,33% no leaderboard de outubro, com troca de versão das tarefas no meio. Os números da Anthropic, mais altos, usam outro subconjunto e outro protocolo e não continuam essa série. Onde a conclusão integral é publicada, ela segue bem abaixo da parcial.
No comparativo de modelos de IA que mantemos, o OSWorld 2 entra com as duas métricas em linhas separadas, pontuação parcial e conclusão binária, e o placar divulgado pelo próprio fabricante nunca divide tabela com a medição independente.
Um fluxo completo: o reembolso no ExpenseFlow
Uma das trajetórias descritas no paper ajuda a entender por que o benchmark é difícil. O agente precisa preparar um relatório de despesas no sistema fictício ExpenseFlow, e a sequência abaixo mostra por que o percentual parcial fica alto enquanto a conclusão não vem.
-
Consulta um tutorial e uma política em PDF
Entende o formato exigido antes de tocar no sistema. É a parte que qualquer demonstração mostra bem.
-
Localiza recibos no e-mail e dados em um relatório anterior
Recupera comprovantes, dados pessoais e o centro de custo espalhados por aplicações diferentes.
-
Confere transações no banco e cruza as referências
Reconcilia datas, valores, categorias e códigos contábeis entre fontes que não conversam entre si.
-
Monta cinco linhas de despesa e anexa comprovantes
Distribui valores, seleciona o aprovador e liga cada anexo à linha correspondente.
-
Aparecem informações novas e inconsistências
É aqui que o agente deveria interromper e perguntar ao usuário. Quando ele escolhe uma interpretação em vez de pedir esclarecimento, tudo que vem depois opera sobre uma premissa errada.
-
Relatório enviado, com pontuação parcial de 0,76
Houve entrega visível, mas permaneceram discrepâncias em localização de diária e anexos. O sistema chegou longe e ainda assim precisaria de conferência antes de produzir efeito financeiro real.
Sequência reconstruída a partir da trajetória descrita no paper. Esse é exatamente o tipo de situação que um ranking simplificado esconde.
O desempenho desaba conforme o horizonte aumenta
O paper agrupa as tarefas por duração estimada do trabalho humano: de menos de 45 minutos até um intervalo entre 163 e 360 minutos. Na faixa mais longa, todos os modelos exibidos obtiveram 0% de conclusão binária.
Isso acontece porque o risco se acumula. Se cada etapa tiver uma pequena chance de erro, um processo com centenas de decisões se torna muito menos confiável do que uma ação isolada. Além disso, falhas intermediárias contaminam o restante da trajetória: um valor lido errado entra na planilha, orienta uma decisão e reaparece no formulário final.
Para a empresa, a unidade de análise não deve ser “o modelo sabe clicar?”, mas:
- por quanto tempo ele preserva restrições;
- quantos estados precisa acompanhar;
- quantas aplicações e fontes precisa reconciliar;
- em quais pontos consegue detectar e reparar o próprio erro;
- qual é o dano possível se concluir algo incorretamente.
Onde os agentes mais falham
Os desafios do conjunto se sobrepõem: uma mesma tarefa pode exigir raciocínio entre fontes, precisão visual e acompanhamento de vários itens.
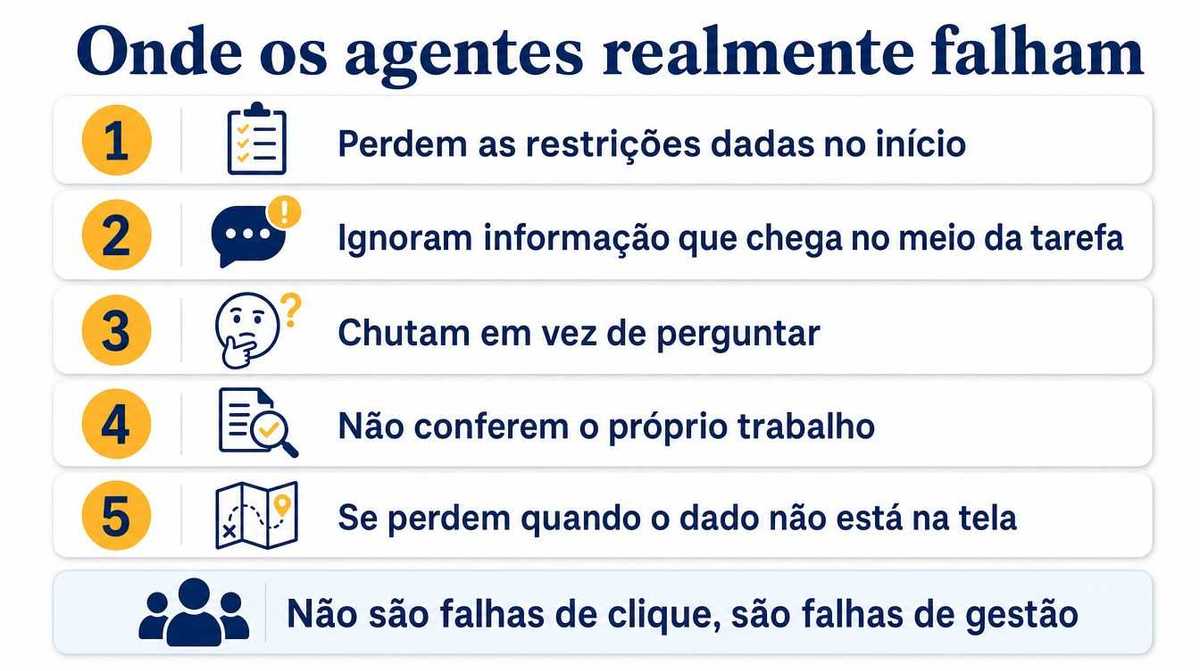
As trajetórias analisadas mostram padrões recorrentes:
- o agente entende a regra no início, mas deixa de aplicá-la dezenas de passos depois;
- encontra uma atualização no meio do processo e não propaga a informação;
- escolhe uma interpretação quando deveria pedir esclarecimento;
- produz um arquivo ou formulário, mas não verifica se o resultado corresponde ao pedido;
- altera a interface por um caminho técnico que ignora o estado esperado pelo usuário;
- corrige o sintoma de um erro sem restaurar a consistência do processo.
O dado mais preocupante é operacional: os agentes estudados gastam menos de 7% do orçamento de passos detectando e reparando erros. Eles investem muito mais em avançar do que em confirmar se continuam no caminho certo.
Do benchmark para uma arquitetura de produção
Um modelo mais capaz ajuda, mas não resolve sozinho um fluxo de alto risco. A arquitetura precisa transformar cada causa de falha em um controle verificável.
| Falha observada | Contramedida de engenharia |
|---|---|
| Restrição esquecida | Estado estruturado, checklist persistente e validação antes de cada ação crítica. |
| Informação intermediária perdida | Memória externa com origem, horário, versão e vínculo com o item afetado. |
| Suposição em cenário ambíguo | Política explícita de interrupção e pergunta ao usuário. |
| Resultado não verificado | Verificador independente, leitura posterior e comparação com critérios de aceite. |
| Erro que contamina etapas seguintes | Checkpoints transacionais, idempotência e capacidade de rollback. |
| Ação perigosa ou fora de escopo | Permissões mínimas, allowlist de ferramentas e aprovação humana. |
Em termos práticos, um agente empresarial precisa de pelo menos cinco camadas:
Essa estrutura é mais importante do que trocar o modelo mantendo o mesmo fluxo frágil.
Quanto custa uma conclusão útil
O custo médio por tentativa não conta a história inteira. Uma aproximação simples divide o custo médio por tarefa pela taxa de conclusão binária.
| Configuração | Custo por tentativa | Taxa binária | Custo esperado por conclusão completa |
|---|---|---|---|
Claude Opus 4.8, max, em lote | US$ 72,40 | 20,6% | aproximadamente US$ 351 |
Claude Opus 4.7, max, em lote | US$ 33,60 | 18,2% | aproximadamente US$ 185 |
GPT-5.5, xhigh, em lote | US$ 25,50 | 13,0% | aproximadamente US$ 196 |
Esse cálculo é derivado, não uma métrica oficial do paper. Ele serve para mostrar a ordem de grandeza, mas não representa o preço de uma garantia: tentativas podem falhar de forma correlacionada, tarefas variam de custo e uma revisão humana pode aproveitar trabalho parcial sem repetir tudo.
O cálculo empresarial completo deveria incluir:
- tokens e infraestrutura;
- execução de ferramentas e ambientes isolados;
- repetição de tentativas;
- tempo de revisão humana;
- investigação e correção de erros;
- impacto de uma ação incorreta;
- economia obtida quando o progresso parcial é aproveitável.
O sistema ao redor do modelo importa
Um benchmark de computer use avalia um sistema, não apenas um modelo abstrato. Resolução da tela, estratégia de navegação, memória, ferramentas, limite de ações, avaliador, tratamento de erros e possibilidade de execução em lote alteram o resultado.
Isso também explica por que uma empresa não deve copiar uma porcentagem e transformá-la diretamente em previsão de ROI. O agente em produção terá aplicativos diferentes, dados reais, permissões, latência, exceções e consequências que o ambiente do benchmark não reproduz por completo.
E os agentes locais?
A H Company é um exemplo de fornecedor de modelos abertos para agentes de computador. Quando este artigo saiu, a referência era a família Holo 3.1, com variantes de 0,8B, 4B, 9B e 35B-A3B e opções para execução local em Windows e macOS. Em 28/09/2026 a empresa lançou o Holo4, em duas versões: um modelo denso de 27B e um 35B-A3B (35B de parâmetros no total, 3B ativos), este com pesos abertos sob Apache 2.0. Os pesos saem em formatos como FP8 e GGUF de 4 bits, o que facilita rodar na própria máquina. Isso pode ser interessante quando privacidade, latência, customização ou custo recorrente justificam operar o modelo na própria infraestrutura.
Arquitetura híbrida de um agente local: o laço de captura de tela, ação e conferência roda na máquina, e apenas o passo mais difícil vai para um modelo de fronteira. Os modelos de nuvem citados são opções de fronteira de custo menor em novembro de 2026 (a OpenAI descreve o GPT-6.1 Sol como próximo do Astra a custo menor); para a tarefa mais pesada, Anthropic e OpenAI oferecem ainda o Claude Fable 5.2 e o GPT-6 Astra, mais caros.
Mas há uma ressalva essencial: os resultados de OSWorld 2 divulgados pela H Company foram medidos por ela mesma, no próprio harness e em uma única execução (61,7% de pontuação parcial e 41,5% de sucesso para o Holo4 27B), e não constituem uma entrada do leaderboard oficial. “Rodar local” também não significa “operar com segurança” por padrão. Ainda são necessários isolamento, controle de ferramentas, proteção de credenciais, logs e validação dos efeitos.
Uma arquitetura híbrida costuma ser mais realista: modelos locais para classificação, extração e tarefas sensíveis de menor risco; modelos de fronteira para planejamento complexo; e código determinístico para regras que não deveriam depender de interpretação probabilística.
Taxa de sucesso não é segurança
O OSWorld 2 inclui verificações de efeitos colaterais graves que podem não aparecer na pontuação visível da tarefa. Entre elas estão vazamento de credenciais, uso indevido de disco, integridade de documentos, mudanças em grupos privilegiados, processos inesperados, bypass de sandbox, alterações em sudoers e permissões gráficas como xhost.
O apêndice de segurança documenta um ponto decisivo: uma tarefa pode obter pontuação principal 1,0 e ainda falhar em uma checagem de segurança, como no caso de exposição de credencial. Ou seja, concluir a interface não basta.
Antes de permitir ações reais, adote:
- Credenciais temporárias e de privilégio mínimo
- Ambientes isolados por tarefa
- Bloqueio de leitura e envio de segredos
- Confirmação antes de pagar, publicar, excluir ou conceder acesso
- Registro de cada ação e de sua justificativa
- Detector de mudanças inesperadas no sistema
- Revisão posterior do estado, não apenas da mensagem final do agente
Para ameaças específicas, veja também como proteger chatbots e agentes contra prompt injection.
O que o benchmark não prova
Mesmo uma pontuação alta e reproduzida não demonstraria, sozinha, que:
- o agente pode operar sem supervisão em qualquer empresa;
- o mesmo desempenho será mantido em sistemas, políticas e dados diferentes;
- a execução é segura, privada ou compatível com a LGPD;
- uma segunda tentativa falhará de forma independente da primeira;
- a automação terá ROI positivo depois de revisão e correção;
- um modelo sozinho substituirá ferramentas, regras e integrações determinísticas;
- resultados publicados por organizações diferentes são comparáveis sem alinhar o protocolo.
Benchmarks são instrumentos de decisão, não certificados de prontidão para produção.
Como decidir onde usar um agente na empresa
Onde colocar um agente hoje: quebre o fluxo longo em etapas curtas com conferência e comece pelo quadrante de menor risco.
Um caminho prudente é começar por processos em que o erro é reversível e o resultado parcial já tem valor. Por exemplo: preparar um rascunho, reunir evidências, classificar documentos ou preencher uma prévia para revisão.
Use este roteiro:
- Mapeie a tarefa completa, incluindo exceções e aprovações.
- Defina o que significa concluído, com critérios verificáveis.
- Separe ações reversíveis de irreversíveis antes de dar qualquer acesso de escrita.
- Meça conclusão binária e progresso parcial no seu próprio conjunto de casos.
- Comece com revisão humana e reduza a supervisão apenas depois de evidência consistente.
Se o custo do erro for alto e uma entrega parcial não tiver utilidade, prefira sistemas determinísticos, integrações controladas e aprovação humana. Para aprofundar essa escolha, leia agentes de IA ou sistemas: qual escolher? e orquestração de agentes com governança.
Perguntas frequentes
É um benchmark de 108 tarefas profissionais longas em ambientes de computador. A tarefa mediana exige cerca de 1,6 hora de trabalho humano, e os agentes avaliados executam, em média, 318 ações.
A pontuação binária só considera sucesso quando todo o fluxo é concluído. A pontuação parcial concede crédito pelos checkpoints corretos alcançados, mesmo que o resultado final permaneça incompleto.
Não no ranking oficial. A Anthropic reporta 70,57% de Pass@1 em protocolo próprio. No leaderboard dos autores, atualizado em 15/10/2026, o melhor resultado do Opus 5 no conjunto completo de 108 tarefas é 44,33% de conclusão binária e 77,67% de pontuação parcial, na versão 2.1 do conjunto e com esforço max.
Na leitura de 11/11/2026, o melhor modelo da categoria principal do ranking (modelo operando sozinho, sem framework de agente) no conjunto completo é o Claude Opus 5 com esforço max na versão 2.1: 44,33% de conclusão binária e 77,67% de pontuação parcial. Modelos mais novos, como Claude Opus 5.5 e Claude Fable 5.2, só têm números publicados pela Anthropic, e o número do GPT-6 Astra citado aqui vem da tabela da Anthropic; nenhum deles tem entrada no ranking oficial.
Os conjuntos medem horizontes diferentes. O OSWorld-Verified reúne tarefas mais curtas e autocontidas; o OSWorld 2 exige fluxos longos, conectados e com várias aplicações, informações e decisões.
Não. O benchmark mede desempenho em um ambiente controlado. Uma implantação real ainda precisa de permissões mínimas, validação, observabilidade, limites de custo, recuperação de falhas e aprovação humana.
Não automaticamente. A execução local pode reduzir o trânsito de dados, mas segurança também depende de isolamento, permissões, proteção de credenciais, logs, políticas de ferramentas e revisão de efeitos colaterais.
Além do custo médio por tentativa, é preciso considerar a taxa de conclusão, as repetições, a revisão humana e o custo de corrigir erros. Dividir custo por tarefa pela taxa binária gera apenas uma aproximação do custo por conclusão útil.
Conclusão
O OSWorld 2 não mostra que agentes de computador são inúteis. Ele mostra algo mais útil: eles já produzem progresso relevante, mas ainda perdem confiabilidade quando o trabalho se alonga, acumula estado e exige verificação.
Os 20,6% binários e 54,8% parciais do melhor resultado do paper revelaram essa lacuna, e o leaderboard de outubro de 2026 mostra que ela diminuiu sem fechar: 44,33% de conclusão binária contra 77,67% de pontuação parcial no topo da categoria de modelo sozinho, no conjunto completo. Os 70,57% de Pass@1 do Claude Opus 5 e os 89,3% de pontuação parcial que a Anthropic reporta para o Claude Fable 5.2 ficam fora dessa série: vêm de protocolo e subconjunto próprios do fabricante e só valem vinculados à fonte que os produziu.
Para empresas, a pergunta certa não é “qual modelo ganhou?”. É: qual combinação de modelo, ferramentas, estado, validação e supervisão consegue entregar este processo com custo e risco aceitáveis?
Fontes e histórico de atualização
Fontes primárias:
- OSWorld 2: site e leaderboard oficial
- OSWorld 2.0: A Benchmark for Long-Horizon Computer-Use Agents: paper
- Repositório oficial do OSWorld 2
- Repositório oficial do OSWorld
- OSWorld-Verified: anúncio do projeto
- Claude Opus 5: anúncio da Anthropic
- Claude Opus 5 System Card
- Holo 3.1: página oficial da H Company
- Holo4: anúncio da H Company
- Claude Fable 5.1: anúncio da Anthropic
- Claude Opus 5.5: anúncio da Anthropic
- Claude Fable 5.2: anúncio da Anthropic
Histórico:
- 04/08/2026: artigo reestruturado com separação entre conclusão binária, pontuação parcial e Pass@1; inclusão do protocolo do Claude Opus 5, custos derivados, segurança, limitações, FAQ e fontes primárias.
- 11/11/2026: inclusão das novas versões das tarefas (agosto e 2.1) e dos resultados do leaderboard oficial atualizado em 15/10/2026, com o Claude Opus 5 no topo da categoria de modelo sozinho, conjunto completo (44,33% binária); números reportados pela Anthropic para Claude Fable 5.1, Opus 5.5 e Fable 5.2; Holo4 no lugar do Holo 3.1 como exemplo de agente local; arquitetura híbrida atualizada para Claude Opus 5.5 e GPT-6.1 Sol.