Índice do artigofaltam 21 min de leitura
A regra de bolso: o modelo define a tarifa por token (na linha atual do Codex, o GPT-6 Astra custa 100x o GPT-6 Luna; o GPT-6.1 Sol, 20x; o GPT-6.1 Terra, 10x). O esforço de raciocínio define quantos tokens a tarefa vai gastar, e o Max dá a um único agente mais tempo para raciocinar. O Ultra multiplica tudo, porque pode delegar o trabalho a vários subagentes e os tokens de todos entram na conta. Quem entende essas alavancas tende a gastar muito menos crédito para entregar o mesmo resultado.
Atualizado em 10 de novembro de 2026. A primeira versão deste guia, de 30 de julho, foi escrita sobre a família GPT-5.6 (Sol, Terra e Luna) e sobre o GPT-5.3 Codex Spark. Desde então, o Spark foi aposentado em 14 de setembro de 2026, o GPT-5.4 saiu do Codex com login do ChatGPT em 31 de agosto e a lista de modelos recomendados pela OpenAI para o Codex passou a ser GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra e GPT-6 Luna. O GPT-5.6 não foi aposentado: segue cobrado na tabela de créditos, mas é geração anterior e está fora da lista de recomendados. Tabelas, fórmula, margens e matriz abaixo foram refeitas com a tabela vigente. Benchmarks citados continuam sendo os da geração GPT-5.6 e estão marcados assim.
Desde abril de 2026, o Codex cobra o uso da assinatura do ChatGPT do mesmo jeito que a API cobra desenvolvedores: por token, convertido em créditos. As "mensagens por janela" viraram só uma estimativa que a OpenAI publica para dar ordem de grandeza. A dúvida de quem usa o Codex todos os dias continua a mesma: qual combinação de modelo e esforço entrega o resultado gastando menos?
Este guia responde com números oficiais: as tarifas de cada modelo, a fórmula que explica o consumo, o que o Ultra faz de verdade com seus créditos e as comparações que importam na prática. Ele complementa o nosso guia de qual modelo escolher entre Sol, Terra e Luna, escrito na geração GPT-5.6: lá, o critério é capacidade; aqui, o critério é custo. Para a cota que Work e Codex dividem e a mudança anunciada para dezembro, veja o limite compartilhado entre ChatGPT e Codex.
Tarifas mudam com frequência: trate a página oficial de preços do Codex como fonte de verdade e o painel Configurações do Codex → Uso (Codex Settings → Usage) como o medidor da sua conta.
Como o Codex cobra em 2026
O Codex cobra por token convertido em créditos: cada tarefa consome tokens de entrada, entrada cacheada e saída (incluindo o raciocínio), e o total é multiplicado pela tarifa do modelo escolhido. Os planos pagos incluem uma franquia de uso; o que passar dela pode ser pago com créditos comprados.
Quatro regras explicam o sistema inteiro:
- Tudo é token. Cada tarefa consome tokens de entrada (o contexto que o modelo lê), tokens de entrada cacheada (contexto repetido, bem mais barato) e tokens de saída. A cobrança por mensagem acabou em abril de 2026.
- Raciocínio é saída. Os tokens que o modelo gasta "pensando" são cobrados como tokens de saída, mesmo que você nunca os veja. É por isso que subir o esforço de raciocínio aumenta o consumo sem mudar a tarifa.
- A franquia do plano vem primeiro. No Plus e no Business Standard, a franquia tem uma janela de 5 horas e pode ter também um limite semanal; os planos Pro, em nov/2026, não têm a janela de 5 horas. Quando a franquia acaba, Plus e Pro podem continuar com créditos comprados. Nos planos pessoais, créditos valem 12 meses, e Work e Codex dividem o mesmo uso: o ChatGPT Work desconta da mesma franquia, com os mesmos preços e créditos do Codex.
- A estimativa oficial agora é por janela, não por mensagem. Em nov/2026, a OpenAI estima quantas mensagens locais cabem em 5 horas do Plus: de 5 a 45 no GPT-6 Astra, de 15 a 160 no GPT-6.1 Sol, de 35 a 285 no GPT-6.1 Terra e de 350 a 3.000 no GPT-6 Luna. A empresa avisa que não são limites fixos e que tarefas na nuvem podem gastar mais. Para quem ainda usa a geração anterior, a mesma página diz que uma tarefa típica do GPT-5.6 Sol pode usar de 2 a 15 créditos.
O rate card do Codex: tarifas oficiais por modelo
Valores da página de preços do Codex em 10 de novembro de 2026, na velocidade Standard, em créditos por 1 milhão de tokens. A OpenAI avisa que o preço em créditos, sozinho, não determina quanto cabe na franquia incluída no plano; ele mostra a proporção entre os modelos.
| Modelo | Entrada | Entrada cacheada | Saída (inclui raciocínio) | Custo relativo |
|---|---|---|---|---|
| GPT-6 Astra | 250 | 25 | 1.250 | 100x Luna |
| GPT-6.1 Sol | 50 | 2,5 | 250 | 20x Luna |
| GPT-6.1 Terra | 25 | 1,25 | 125 | 10x Luna |
| GPT-6 Luna | 2,5 | 0,25 | 12,5 | 1x |
A mesma tabela ainda cobra o GPT-6 Sol (50 / 5 / 250), antecessor do 6.1 Sol que ainda aparece em presets de potência, e a família GPT-5.6, de geração anterior e fora da lista de recomendados: GPT-5.6 Sol (100 / 10 / 500, preço promocional garantido pelo menos até 21 de novembro de 2026), GPT-5.6 Terra (50 / 5 / 300) e GPT-5.6 Luna (5 / 0,5 / 30).
Três proporções valem para a linha atual e simplificam qualquer conta:
- Saída custa 5x a entrada nos quatro modelos recomendados. Uma tarefa que escreve ou raciocina muito pesa mais do que uma tarefa que só lê muito. (Na família GPT-5.6, Terra e Luna seguem em 6x; o GPT-5.6 Sol, no preço promocional, ficou em 5x.)
- Ler do cache custa 1/10 da entrada no Astra e no Luna, e 1/20 no GPT-6.1 Sol e no GPT-6.1 Terra. Reaproveitar contexto em uma mesma sessão reduz muito o consumo, e o Codex não cobra gravação de cache à parte no faturamento em créditos.
- Astra = 5x Sol = 10x Terra = 100x Luna, por token de entrada ou de saída. Na entrada cacheada, a distância do Luna para o GPT-6.1 Sol e o GPT-6.1 Terra cai pela metade (10x e 5x), porque o cache dos 6.1 tem desconto maior; já a distância entre Astra e Sol sobe para 10x.

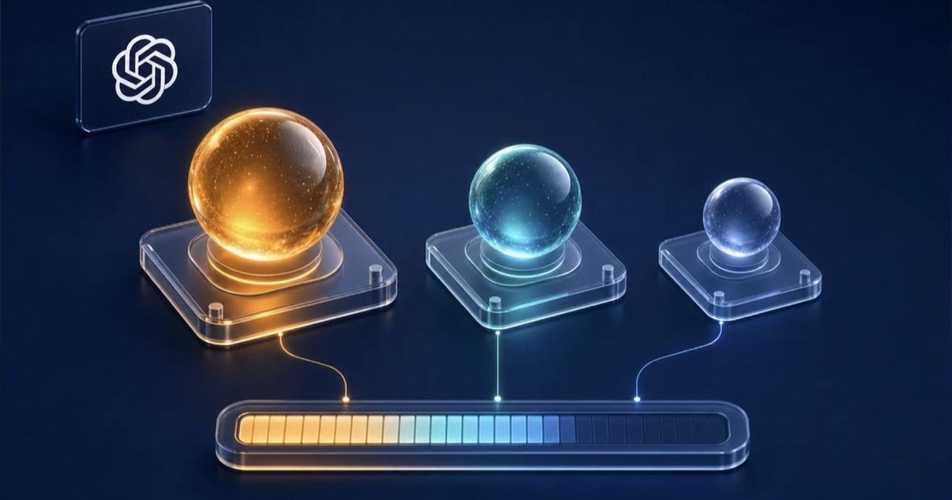
O infográfico acima mostra a tabela de julho, da família GPT-5.6, quando o Sol custava 25x o Luna. A proporção da linha atual está na tabela de texto.
O histórico de 30 de julho: naquele dia a OpenAI reduziu os preços da família GPT-5.6: Terra ficou 20% mais barato e Luna, 80% mais barato na API, com o corte refletido também no consumo das assinaturas. O rate card do Codex daquele dia cobrava 125 / 12,5 / 750 no GPT-5.6 Sol. Em novembro, o GPT-5.6 Sol aparece a 100 / 10 / 500 em preço promocional, e a geração GPT-6 virou a referência de custo.
A fórmula que explica o consumo de créditos do Codex
Como a saída custa 5x a entrada em todos os modelos recomendados, dá para resumir qualquer execução em uma unidade ponderada:
W = E + k × C + 5 × S

E = tokens de entrada não cacheados
C = tokens de entrada cacheados
S = tokens de saída, incluindo raciocínio
k = 0,1 no GPT-6 Astra e no GPT-6 Luna; 0,05 no GPT-6.1 Sol e no GPT-6.1 Terra

Créditos = W × tarifa de entrada do modelo ÷ 1.000.000
Exemplo: uma tarefa que lê 100 mil tokens novos e produz 20 mil tokens de saída e raciocínio tem W = 200.000. O custo nos quatro modelos:
| Modelo | Créditos na mesma execução |
|---|---|
| GPT-6 Luna | 0,5 |
| GPT-6.1 Terra | 5 |
| GPT-6.1 Sol | 10 |
| GPT-6 Astra | 50 |
Essa tabela carrega a lição mais importante do guia: com o mesmo volume de tokens, a mesma tarefa custa 100x mais no Astra do que no Luna, e 20x mais no GPT-6.1 Sol. O esforço de raciocínio não muda a tarifa; muda o S da fórmula. Subir o esforço em um modelo barato costuma custar menos do que descer o esforço em um modelo caro.
Esforço de raciocínio: a segunda alavanca
O esforço de raciocínio do Codex define quantos tokens o modelo dedica a pensar antes de responder. Ele não muda a tarifa por token: muda o volume de tokens de saída, então o mesmo nível custa valores muito diferentes em Luna, Terra, Sol e Astra.
Na documentação de nov/2026, os níveis são Light (Leve no aplicativo em português), ou low no CLI, depois Medium, High e Extra High, e acima deles Max e Ultra. A OpenAI recomenda começar no esforço padrão do cliente no GPT-6.1 Sol, em High no Luna e em Light no Astra, e avisa que os níveis não correspondem exatamente entre gerações: o Alto do GPT-6 não equivale necessariamente ao Alto do GPT-5.6. Nos guias da X-Apps chamamos o primeiro nível de Baixo e o Máximo de Max, por consistência com os demais artigos da série.
O ponto central: não existe tabela oficial de "quanto custa cada esforço". Extra alto não custa "2x o Médio"; ele apenas tende a gastar mais tokens de raciocínio, e cada token segue a tarifa do modelo. O mapa realista das interseções:
| Modelo \ esforço | Baixo | Médio | Alto | Extra alto | Max | Ultra |
|---|---|---|---|---|---|---|
| GPT-6 Luna | 1x, tokens baixos | 1x | 1x, mais tokens | 1x, muitos tokens | 1x, um agente pensando mais | não há |
| GPT-6.1 Terra | 10x, tokens baixos | 10x | 10x, mais tokens | 10x, muitos tokens | 10x, um agente pensando mais | 10x, multiagente, se disponível |
| GPT-6.1 Sol | 20x, tokens baixos | 20x | 20x, mais tokens | 20x, muitos tokens | 20x, um agente pensando mais | 20x, multiagente |
| GPT-6 Astra | 100x, tokens baixos | 100x | 100x, mais tokens | 100x, muitos tokens | 100x, um agente pensando mais | 100x, multiagente |
A documentação diz expressamente que o GPT-6 Luna vai até o Max, mas não tem Ultra. Nos demais, o Ultra depende de conta elegível e de modelo suportado; a documentação de novembro de 2026 não lista quais modelos têm Ultra além de excluir o Luna, então confira no seu seletor.
Duas consequências práticas que surpreendem quem está começando:
- Luna Extra alto pode ser muito mais barato que Terra Baixo. Para empatar em créditos, o Luna precisaria gastar 10x mais tokens ponderados na mesma tarefa, o que raramente acontece.
- Terra Ultra, onde disponível, pode ficar mais caro que Sol Extra alto. A tarifa do GPT-6.1 Sol é 2x a do GPT-6.1 Terra; se os agentes do Ultra gerarem juntos mais de 2x os tokens, a conta vira.
Codex Ultra: o que a delegação automática faz com seus créditos
O modo Ultra do Codex não é "um esforço acima do Max". A documentação oficial o descreve como raciocínio máximo com permissão para o ChatGPT delegar por conta própria partes do trabalho a subagentes que rodam em paralelo; nos outros níveis, você precisa pedir subagentes explicitamente. A mesma documentação avisa que fluxos com subagentes consomem mais tokens do que uma execução comparável com um agente só. Nas avaliações publicadas em julho para o GPT-5.6, o Ultra rodava com 4 agentes por padrão (havia configurações divulgadas com até 16); a documentação de nov/2026 não fixa um número e deixa o Codex escolher o padrão quando você não configura o limite de agentes simultâneos.
O ganho existe e foi medido na geração anterior: no anúncio do GPT-5.6, o Sol em modo Ultra subiu o Terminal-Bench 2.1 de 88,8 para 91,9 e o BrowseComp de 90,4 para 92,2. É um ganho de poucos pontos que pode multiplicar o gasto da tarefa, então a decisão certa depende do formato do trabalho, não da dificuldade em si.
Use Ultra quando as quatro condições estiverem presentes:
- Você consegue nomear pelo menos três frentes independentes do trabalho.
- Cada frente produz resultado útil sem esperar pelas outras.
- A maior parte é leitura, exploração, teste ou comparação, não edição dos mesmos arquivos.
- Terminar mais rápido e cobrir tudo vale mais do que economizar créditos.
Prefira um agente único (Extra alto ou Max) quando:
| Sinal | Por quê |
|---|---|
| Cada etapa depende da anterior | Não há paralelismo real para explorar |
| Todos os agentes mexeriam nos mesmos arquivos | Risco de soluções concorrentes e conflito |
| Há uma única sessão autenticada no navegador | Estado compartilhado pede um responsável só |
| A causa precisa ser rastreada ponta a ponta | Dividir quebra a cadeia de evidência |
| O resultado precisa de uma única voz | Um agente central preserva coerência |
| Já existe diagnóstico e falta implementar | Ultra só adicionaria overhead |

Codex Max: a profundidade máxima de um agente só
Entre o Extra alto e o Ultra existe um nível que muita gente ainda não viu no seletor: o Max. A escala completa de profundidade funciona assim:
- Extra alto: raciocínio muito profundo de um agente.
- Max: o modelo escolhido recebe mais tempo para raciocinar sobre uma única tarefa.
- Ultra: raciocínio máximo com delegação automática para subagentes.
Para a conta de créditos, a distinção importa: Max não tem tarifa própria. Ele custa mais porque gera muito mais tokens de raciocínio e verificação, mas o consumo continua limitado a um agente, o que o torna bem mais previsível que o Ultra. A orientação oficial é reservá-lo para os problemas mais difíceis, quando profundidade importa mais que velocidade ou consumo; a própria documentação lembra que a maioria das tarefas não precisa de Max nem de Ultra.
Se o problema é indivisível e muito difícil, a escalada natural é Alto, Extra alto e só então Max. Se o problema é divisível em frentes, o caminho é o Ultra. Errar essa classificação custa caro nos dois sentidos: Max em tarefa paralelizável desperdiça tempo; Ultra em tarefa linear desperdiça agentes.
A margem do Max: quando um modelo menor vence um maior
O Max cria as interseções mais interessantes da tabela de tarifas: um modelo barato raciocinando no máximo contra um modelo caro raciocinando pouco. A aritmética do rate card de nov/2026 define a margem de cada duelo:
| Duelo | Margem do modelo menor |
|---|---|
| GPT-6.1 Sol Max contra GPT-6 Astra Baixo | Pode gastar até 5x os tokens e ainda empatar |
| GPT-6.1 Terra Max contra GPT-6.1 Sol Baixo | Pode gastar até 2x os tokens |
| GPT-6 Luna Max contra GPT-6.1 Terra Baixo | Pode gastar até 10x os tokens |
| GPT-6 Luna Max contra GPT-6.1 Sol Baixo | Pode gastar até 20x os tokens |
A conta usa entrada e saída, onde as proporções são exatas. Em tarefa dominada por cache, a margem entre o Luna e os modelos 6.1 encolhe pela metade, porque o cache dos 6.1 tem desconto maior.
E não é só teoria. Nos resultados que a OpenAI publicou em julho para o GeneBench-Pro, um benchmark difícil de análise quantitativa em biologia, o cruzamento apareceu na prática na geração GPT-5.6: Terra Max marcou 23,3% contra 14,4% do Sol em esforço baixo, e Luna Max marcou 16,5%, também acima do Sol em esforço baixo, gastando cerca de 21 vezes mais tokens de raciocínio. Na tarifa de julho, em que o Sol custava 25x o Luna, o Luna Max entregou resultado melhor custando aproximadamente 16% menos créditos que o Sol em esforço baixo; já o Terra Max ficou quase 4 vezes mais caro, porque sua margem era de apenas 2,5x. A OpenAI não publicou essa medição para a linha GPT-6. Vale a lição de método: com a margem atual de 20x entre o GPT-6 Luna e o GPT-6.1 Sol, a mesma proporção de 21x em tokens já não sairia mais barata.

O infográfico acima usa as margens de julho (2,5x, 10x e 25x). As margens vigentes estão na tabela de texto.
A leitura correta dessas interseções:
- Luna Max brilha em tarefa fechada, textual e verificável: implementação com testes objetivos, transformação de dados com regras claras, auditoria contra checklist. A margem de 20x contra o GPT-6.1 Sol dá espaço enorme para raciocinar barato.
- Terra Max é o especialista em investigação profunda: um bug causal difícil, uma migração sequencial delicada, uma análise lógica extensa. Mas cuidado ao usá-lo como "Sol barato": a margem de 2x se esgota rápido.
- Sol Max é a alternativa ao Astra: a OpenAI descreve o GPT-6.1 Sol como desempenho próximo do Astra a custo menor, e a margem de 5x permite raciocinar bastante antes de empatar.
- Esforço não substitui modelo onde a capacidade manda. Em navegação visual, contexto muito longo e acabamento, a distância entre os modelos é estrutural: nos números publicados para a geração GPT-5.6, o Terra mantinha 89,6% em contexto de 256 a 512 mil tokens, enquanto o Luna ficava em 41,3%. Nenhum Max compensa uma diferença dessa ordem. Para Chrome e Computer Use, escolha o modelo antes do esforço.
Onde o Max aparece (e o que fazer quando some)
O Max tem uma particularidade operacional que gera dúvida frequente: ele pode não aparecer no seletor, dependendo do aplicativo, da versão e da configuração. Em julho, a documentação orientava habilitá-lo nas configurações quando estivesse ausente. O que resolvia na prática:
- Habilite nas configurações do app: no aplicativo em português, o caminho era Configuração → Recursos do modelo → Esforços de raciocínio disponíveis (em inglês, Settings → Model features → Available reasoning efforts). Abra a lista e marque Máximo e Ultra; com tudo ativo, o seletor mostra "6 selecionados", como na tela abaixo. Há ainda um ajuste separado, "Ultra no slider do seletor de modelos", que exibe o Ultra como a opção mais alta do controle deslizante. Depois, encerre o aplicativo e crie uma tarefa nova, porque modelo e esforço ficam associados à tarefa atual.
 2. Use o seletor avançado, não o controle resumido de potência: houve relatos no repositório oficial do Codex de que o controle deslizante simplificado pulava do Extra alto direto para o Ultra mesmo com o Max habilitado. O caminho confiável era Avançado → Esforço. Em nov/2026, a documentação passou a descrever presets de potência com combinações prontas de modelo e esforço (Luna High, GPT-6 Sol Light, GPT-6 Sol Medium, Astra Light, Astra Medium e Astra Extra High).
3. No CLI, o Max virou oficial em julho: a partir da versão 0.144.0, o comando
/model passou a exibir a sequência completa, incluindo Max entre Extra alto e Ultra. Confira no cliente atual, porque o caminho pode ter mudado desde então.
4. Clientes diferentes, catálogos diferentes: o Codex faz parte do aplicativo desktop do ChatGPT desde julho de 2026, e as interfaces de iPhone, desktop e CLI têm ciclos de atualização próprios. O catálogo também muda por cliente: em nov/2026, a documentação lista o GPT-6.1 Terra no app desktop, no Work na web e no CLI, mas não na extensão de IDE.
Uma alternativa intermediária pouco conhecida: subagentes sob controle fora do Ultra. Em qualquer esforço, você pode pedir explicitamente "use dois subagentes, um para os logs e outro para o banco, sem alterar nada, e consolide". Nos clientes locais, dá para ir além e configurar subagentes com modelo e esforço próprios em arquivos TOML (~/.codex/agents/ para agentes pessoais ou .codex/agents/ no projeto). A documentação de nov/2026 sugere agentes em paralelo para tarefas de leitura (exploração, testes, triagem, resumo), o GPT-6 Luna para agentes rápidos e de escopo estreito e o GPT-6.1 Sol para trabalho ambíguo, de vários passos, que pede planejamento e validação. Essa composição costuma sair mais barata que um Ultra no modelo forte, porque o modelo caro não é gasto em investigação de rotina.
O que aconteceu com o Codex Spark
Na primeira versão deste guia, o GPT-5.3 Codex Spark era o caso à parte da conta de créditos: em research preview para assinantes Pro, tinha limites próprios, fora da franquia e do saldo, e por isso as alterações pequenas e interativas feitas nele eram as mais baratas da assinatura.
Esse atalho acabou. O Spark foi aposentado em 14 de setembro de 2026 e não está mais disponível no aplicativo desktop do ChatGPT, no Codex CLI nem na extensão de IDE. A OpenAI pede que configurações salvas, agentes personalizados e scripts que selecionam gpt-5.3-codex-spark passem a usar um modelo disponível. Para o trabalho interativo e pequeno que ia para o Spark, o candidato natural em custo hoje é o GPT-6 Luna, que tem a menor tarifa da tabela; se a espera incomodar, o Fast mode resolve, com a sobretaxa descrita abaixo.
Fast mode e Ultrafast: o mesmo modelo com sobretaxa de velocidade
O Fast mode serve o mesmo modelo mais rápido. Em nov/2026, ele vale para GPT-6.1 Sol, GPT-6.1 Terra, GPT-6 Astra, GPT-6 Sol e GPT-6 Luna, onde disponível, e para o GPT-5.6 com ganho de velocidade de 1,5x. O consumo muda conforme a origem do uso: 2,5x a tarifa padrão na franquia do plano e 2x em créditos comprados (e no pay-as-you-go do Enterprise). No CLI, o comando é /fast.
O Ultrafast é o degrau seguinte, só no GPT-6 Astra e no GPT-6.1 Sol: no Astra, gera tokens até 8x mais rápido que no modo Standard. Está disponível no Pro de US$ 500 e em planos Enterprise e Edu elegíveis, e custa 8x a tarifa padrão na franquia e 6x em créditos comprados. Os detalhes do plano estão no nosso artigo sobre o ChatGPT Pro de US$ 500 e o Ultrafast.
As comparações que importam
Luna Extra alto vs Terra Baixo vs Terra Médio
A condição de empate é objetiva: GPT-6 Luna Extra alto só custa o mesmo que GPT-6.1 Terra se gastar 10x mais tokens ponderados. Por isso:
| Prioridade | Escolha |
|---|---|
| Menor custo por tarefa | Luna Extra alto |
| Melhor equilíbrio geral | Terra Médio |
| Menor latência no modelo Terra | Terra Baixo |
Terra Baixo é a configuração mais difícil de justificar: para economizar, Luna Extra alto ganha; para confiar, Terra Médio ganha. Use-o quando quiser especificamente o Terra com a menor espera possível.
Terra Ultra vs Sol Alto e Extra alto
Onde o seletor oferecer Ultra no GPT-6.1 Terra (a documentação de nov/2026 não confirma), ele não é "um Sol mais barato". Ele compra cobertura e paralelismo (auditorias de muitos módulos, pesquisa em muitas fontes, testes em vários ambientes). Sol Alto e Extra alto compram julgamento e profundidade (o bug difícil, a decisão de arquitetura, o fluxo delicado no navegador). Com a tarifa do GPT-6.1 Sol em apenas 2x a do GPT-6.1 Terra, para uma tarefa linear difícil o Sol Alto tende a vencer o Terra Ultra em qualidade e em custo, porque evita a multiplicação de agentes.
Sol Alto vs Sol Extra alto vs Sol Max vs Astra
Mesma tarifa nos três primeiros, consumos muito diferentes; o Astra entra como o degrau de modelo, não de esforço:
| Configuração | Quando usar | Eficiência |
|---|---|---|
| GPT-6.1 Sol Alto | Padrão para trabalho difícil: bugs complexos, arquitetura, análise, navegador | Melhor relação da linha atual |
| GPT-6.1 Sol Extra alto | Quando o Alto falhou ou o custo de errar supera o custo de raciocinar mais | Boa em problemas críticos |
| GPT-6.1 Sol Max | O problema mais difícil da fila, indivisível, em que qualidade vem antes de custo | Cara, mas previsível: um agente só |
| GPT-6 Astra Baixo | Quando o Sol Max não deu conta e o trabalho exige o julgamento do modelo mais capaz | Tarifa 5x a do Sol; comece no Baixo (Leve no app), como a OpenAI recomenda |
| Sol ou Astra Ultra, onde disponível | Só para trabalho grande e divisível em frentes independentes | Baixa em tarefas lineares |
Para "melhorar um pouco" uma resposta única, Ultra é a pior escolha da tabela: paga vários agentes para um problema de um agente só. Entre Max e Ultra, a pergunta decisiva não é "quão difícil", e sim "quantas frentes independentes".
Matriz por tipo de trabalho
A matriz abaixo parte do custo: é o menor gasto de créditos que costuma resolver cada tipo de tarefa na linha de nov/2026. Para escolher pela capacidade do modelo, a referência é a página de modelos do Codex, e o nosso guia de Sol, Terra e Luna registra a lógica na geração GPT-5.6.
| Tarefa | Configuração recomendada |
|---|---|
| Alterações rápidas enquanto programa | GPT-6 Luna Baixo ou Médio (Fast mode se a espera incomodar) |
| Bug pequeno e localizado | GPT-6 Luna Alto |
| Implementação clara e delimitada | GPT-6 Luna Extra alto |
| Código bem especificado, com testes objetivos | GPT-6 Luna Max |
| Desenvolvimento cotidiano em repositório | GPT-6.1 Terra Médio (fora da extensão de IDE) ou GPT-6.1 Sol no padrão do cliente |
| Refatoração ou debugging complexo | GPT-6.1 Sol Alto |
| Investigação causal profunda com evidências fechadas | GPT-6.1 Terra Max |
| Arquitetura e problemas críticos | GPT-6.1 Sol Extra alto ou Max; GPT-6 Astra se o Sol não der conta |
| Auditoria de muitos módulos | GPT-6.1 Terra Ultra, onde disponível, ou subagentes Luna sob controle |
| Reescrita e texto curto | GPT-6 Luna Baixo ou Médio |
| Documento executivo importante | GPT-6.1 Sol Alto |
| Pesquisa em muitas fontes paralelas | GPT-6.1 Terra Ultra, onde disponível |
| Automação repetitiva no navegador | GPT-6 Luna ou GPT-6.1 Terra Médio |
| Fluxo visual importante no Chrome | GPT-6.1 Sol Alto |
| Fluxo longo e frágil, com recuperação de erros | GPT-6.1 Sol Extra alto |
No uso de computador e navegador, vale um alerta de custo indireto: na geração GPT-5.6, os benchmarks oficiais mostravam uma distância entre os modelos muito maior em OSWorld 2.0 (Sol 62,6 contra 45,6 do Luna) do que em programação (SWE-Bench Pro: 64,6 contra 62,7). Um modelo barato que erra a navegação gera novas capturas, novas tentativas e mais chamadas: a economia por token pode ser anulada pela repetição do fluxo. A OpenAI hoje posiciona o GPT-6.1 Terra justamente para escrita, compreensão visual e computer use.
Três fluxos que gastam menos que um Ultra contínuo
Os maiores desperdícios acontecem quando uma configuração cara fica ligada do início ao fim. Fluxos em etapas resolvem:
- Explorar amplo, decidir fundo: Terra Ultra (onde disponível) ou subagentes Luna para coletar evidências em paralelo (auditoria, pesquisa, comparação); depois GPT-6.1 Sol Extra alto para a decisão, o diagnóstico ou o documento final com uma única voz.
- Planejar, executar em paralelo, integrar: GPT-6.1 Sol Extra alto define arquitetura, contratos e critérios de aceite; subagentes executam as frentes já especificadas; o Sol integra e valida no final.
- Investigar em paralelo, corrigir centralizado: em um incidente, agentes em modo leitura varrem logs, banco, API e deploy ao mesmo tempo; um único GPT-6.1 Sol Extra alto escolhe a hipótese, aplica o patch e roda a regressão.
A lógica dos três é a mesma: paralelize a leitura, centralize a escrita e reserve o modelo caro para as decisões.
Checklist de 30 segundos antes de rodar
- A tarefa é interativa e pequena? GPT-6 Luna, em esforço baixo ou médio.
- É simples e bem especificada? Luna, subindo o esforço se houver ambiguidade (a OpenAI sugere começar em Alto).
- É trabalho normal de produção? GPT-6.1 Terra Médio ou GPT-6.1 Sol no esforço padrão.
- É difícil, crítica ou ambígua? GPT-6.1 Sol Alto, e Extra alto se o erro custar caro.
- O Sol não deu conta? GPT-6 Astra, começando no Baixo; ele custa 5x o Sol por token.
- É um problema único, fechado e verificável? Um modelo menor em Max pode vencer um maior em esforço baixo.
- Tem três ou mais frentes independentes? Considere Ultra, no menor modelo que dá conta de cada frente (o Luna não tem Ultra).
- Vai reusar muito contexto? Mantenha a mesma sessão para aproveitar o cache a 1/10 ou 1/20 do preço.
- Precisa só de velocidade? Lembre que Fast mode custa 2,5x na franquia (2x em créditos) e o Ultrafast, 8x (6x em créditos).
Perguntas frequentes sobre créditos do Codex
Quanto custa uma tarefa no Codex?
Depende do modelo, do esforço e do contexto. Em nov/2026, a OpenAI estima de 5 a 45 mensagens locais por janela de 5 horas do Plus no GPT-6 Astra, de 15 a 160 no GPT-6.1 Sol, de 35 a 285 no GPT-6.1 Terra e de 350 a 3.000 no GPT-6 Luna, e avisa que não são limites fixos. Para o GPT-5.6 Sol, de geração anterior, a estimativa é de 2 a 15 créditos por tarefa típica. O valor exato da sua conta aparece em Configurações do Codex, na aba Uso.
Onde vejo quanto estou gastando?
Em Configurações do Codex → Uso (chatgpt.com/codex/settings/usage), que mostra a franquia do plano, o consumo recente e o saldo de créditos comprados.
Subir o esforço de raciocínio dobra o custo?
Não existe multiplicador fixo. O esforço aumenta os tokens de raciocínio, cobrados como saída na tarifa do modelo. O aumento real varia por tarefa; em instruções claras e determinísticas, pode ser quase nulo o ganho e alto o custo extra.
O Ultra custa quantas vezes mais?
Não há multiplicador publicado. O Ultra roda raciocínio máximo e pode delegar a subagentes por conta própria, e todos os tokens contam; a documentação avisa que fluxos com subagentes gastam mais tokens que uma execução com um agente só. Em tarefa paralelizável, o custo extra compra tempo e cobertura; em tarefa linear, é desperdício.
Max e Ultra custam o mesmo?
Nenhum dos dois tem tarifa própria; os dois pagam a tarifa do modelo pelos tokens gerados. A diferença está no formato do consumo: o Max dá mais tempo de raciocínio a um único agente, então o gasto cresce, mas de forma limitada e previsível. O Ultra soma os tokens de vários agentes, e o total varia muito com a tarefa.
O Max não aparece no meu seletor. E agora?
Em julho de 2026, o caminho era Configuração → Recursos do modelo → Esforços de raciocínio disponíveis, marcando Máximo (e Ultra, se quiser) na lista, e criando uma tarefa nova. Se o controle resumido de potência pulava do Extra alto para o Ultra, o seletor avançado de esforço resolvia; no CLI, o /model passou a mostrar o Max a partir da versão 0.144.0. Esse caminho não foi reconfirmado em nov/2026, então confira no seu cliente atual. Interfaces de celular, desktop e CLI atualizam em ritmos diferentes, então o nível pode aparecer em um cliente antes do outro.
Luna com esforço alto sai mais caro que Terra com esforço baixo?
Quase nunca. A tarifa do GPT-6.1 Terra é 10x a do GPT-6 Luna, então o Luna precisaria gastar 10x mais tokens ponderados para empatar. Se a tarefa está bem especificada, Luna Extra alto costuma ser a opção mais econômica do seletor.
O Spark ainda existe?
Não. O GPT-5.3 Codex Spark foi aposentado em 14 de setembro de 2026 e saiu do aplicativo desktop, do CLI e da extensão de IDE. Quem tinha gpt-5.3-codex-spark em configuração, agente personalizado ou script precisa trocar por um modelo disponível. A cota separada que ele tinha no research preview acabou junto.
Fast mode e Ultrafast são a mesma coisa?
Não. Os dois servem o mesmo modelo mais rápido, mas o Fast mode vale para os modelos GPT-6.x e para o GPT-5.6 (com ganho de 1,5x) e custa 2,5x na franquia (2x em créditos), enquanto o Ultrafast existe só no GPT-6 Astra e no GPT-6.1 Sol, no Pro de US$ 500 e em Enterprise e Edu elegíveis, e custa 8x na franquia (6x em créditos).
O GPT-5.6 foi aposentado?
Não. Em nov/2026 a tabela de créditos ainda cobra GPT-5.6 Sol, Terra e Luna, mas eles são geração anterior e não estão na lista de modelos recomendados para o Codex. Os aposentados com login do ChatGPT são outros: GPT-5.3 Codex Spark (14/09/2026), gpt-5.4 e gpt-5.4-mini (31/08/2026) e GPT-5.5 (14/10/2026). Quem usa o Codex com chave de API segue as regras e os modelos da API.
Créditos comprados expiram?
Nos planos pessoais, sim, em 12 meses, e não são reembolsáveis, salvo exceções. Work e Codex dividem o mesmo uso: o ChatGPT Work desconta da mesma franquia e dos mesmos créditos.
Os preços de 30 de julho de 2026 ainda valem?
Para a família GPT-5.6, só em parte: Terra e Luna seguem em 50 / 5 / 300 e 5 / 0,5 / 30, e o Sol aparece a 100 / 10 / 500 em preço promocional (era 125 / 12,5 / 750 em julho). Mas a referência de custo agora é a linha GPT-6, com proporções de 100x, 20x, 10x e 1x. Confirme os valores atuais na página oficial antes de fazer contas finas.
Cache realmente economiza?
Sim: ler entrada cacheada custa 1/10 da entrada normal no Astra e no Luna, e 1/20 no GPT-6.1 Sol e no GPT-6.1 Terra. O faturamento do Codex em créditos não cobra gravação de cache à parte, então trabalhar na mesma sessão, em vez de abrir conversas novas com o mesmo contexto, é uma das economias mais fáceis de capturar.
Conclusão
Créditos do Codex não se economizam escolhendo "o modelo mais fraco", e sim alinhando as três alavancas ao formato da tarefa: tarifa (modelo), tokens (esforço) e arquitetura de execução (agente único ou Ultra). O padrão que emerge das tabelas de nov/2026 é simples: GPT-6 Luna para o interativo e o delimitado, GPT-6.1 Terra Médio ou GPT-6.1 Sol no padrão como base, Sol Alto para o que importa, Extra alto para o crítico, Max para o problema indivisível mais difícil da fila, Astra quando o Sol não basta e Ultra apenas quando você consegue nomear as frentes que os subagentes vão executar. E vale lembrar a interseção mais lucrativa do rate card: um modelo menor em Max, com margem de 10x ou 20x para raciocinar, pode entregar mais barato o que um modelo maior faria em esforço baixo.
Para escolher o modelo pela capacidade, consulte a página de modelos do Codex e o nosso guia de Sol, Terra e Luna. Para organizar o processo inteiro da assinatura, veja como aproveitar melhor ChatGPT e Codex sem gastar mais. E se a sua empresa está estruturando agentes de IA em produção, essa mesma disciplina de custo por token vale para qualquer provedor.
Quer colocar IA para trabalhar com custo sob controle?
A X-Apps desenha fluxos de IA para empresas com governança de custo desde o primeiro dia: escolha de modelos, roteamento por tarefa, caching, observabilidade de consumo e agentes em produção.
Fontes oficiais e documentação
- Pricing - ChatGPT Learn (página de preços do Codex e do Work, lida em 10/11/2026)
- Models - ChatGPT Learn (lida em 10/11/2026)
- Speed - ChatGPT Learn (Fast mode e Ultrafast, lida em 10/11/2026)
- Subagents - ChatGPT Learn (lida em 10/11/2026)
- Codex rate card - OpenAI Help Center (versão de julho de 2026)
- Using credits for flexible usage in ChatGPT - OpenAI Help Center
- Using Codex with your ChatGPT plan - OpenAI Help Center
- Reasoning guide - OpenAI API
- GPT-5.6 announcement - OpenAI
- Advancing the price-performance frontier with GPT-5.6 - OpenAI
- Introducing GPT-5.3-Codex-Spark - OpenAI (histórico; modelo aposentado em 14/09/2026)
- GPT-5.6 in ChatGPT - OpenAI Help Center