Índice do artigofaltam 7 min de leitura
Este guia nasceu em março comparando GPT-5.4, GPT-5.3-Codex e Spark. Nenhum dos três está mais disponível no Codex para quem entra com a conta do ChatGPT, e o GPT-5.5, que veio depois, também saiu em 14 de outubro. A versão de 10 de novembro de 2026 mostra o que entrou no lugar de cada um e qual combinação de modelo, esforço e modo usar em cada tipo de tarefa, no Codex e no Claude Code.
O que fazer agora: se algum script, configuração ou agente ainda chama gpt-5.5, gpt-5.4, gpt-5.4-mini ou gpt-5.3-codex-spark com login do ChatGPT, troque pelo substituto da tabela abaixo antes que a próxima tarefa agendada falhe.
O que substituiu GPT-5.4, GPT-5.5 e Spark no Codex
A OpenAI aposentou os modelos da linha 5 no Codex em três datas. As regras abaixo valem para quem entra com a conta do ChatGPT; quem usa o Codex com chave de API segue com o catálogo da API, onde o GPT-5.5 continua disponível.
| Modelo antigo | Saiu do Codex em | Substituto indicado pela OpenAI |
|---|---|---|
| GPT-5.4 | 31/08/2026 | GPT-6 Sol |
| GPT-5.4 mini | 31/08/2026 | GPT-6 Luna |
| GPT-5.3-Codex-Spark | 14/09/2026 | Um modelo disponível no seu plano (não há substituto nomeado) |
| GPT-5.5 | 14/10/2026 | GPT-6.1 Sol (Plus, Pro, Business, Enterprise e Edu) ou GPT-6 Luna (Free e Go) |
| GPT-5.3-Codex e GPT-5.2 | Já depreciados antes | Um modelo da linha atual |
Para fixar o modelo no Codex, a linha do config.toml fica assim: model = "gpt-6.1-sol". O mesmo arquivo vale para o aplicativo, o CLI e a extensão de IDE.
Modelo, esforço e modo não são a mesma coisa
Os dois seletores misturam três decisões diferentes, e boa parte da escolha errada vem de tratar as três como "modelo":
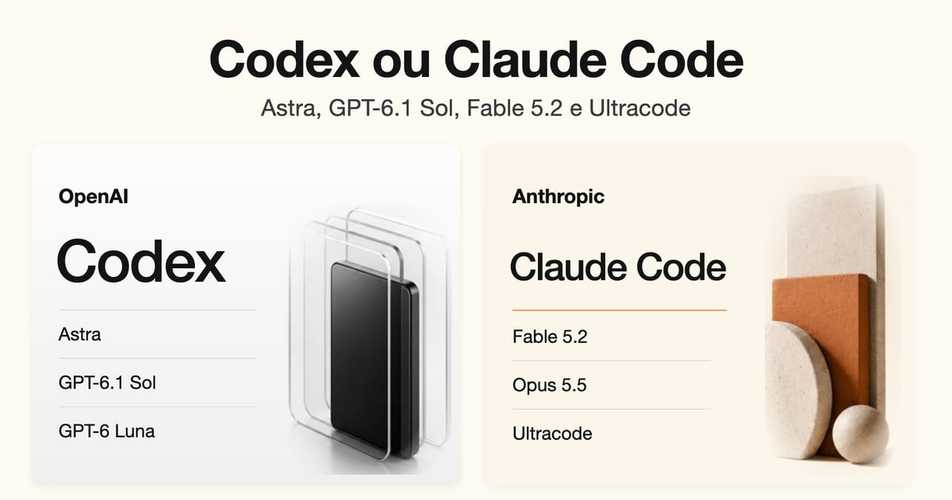
- Modelo: quem executa a tarefa. No Codex, Astra, GPT-6.1 Sol, GPT-6.1 Terra e GPT-6 Luna. No Claude Code, Fable 5.2, Opus 5.5, Sonnet 5.5 e Haiku 5.5.
- Esforço de raciocínio: quanto o modelo pensa antes de agir. No Codex vai de Light (Low no CLI) a Extra High, mais o Max. No Claude Code vai de low a max, passando por xhigh.
- Modo de execução: como a sessão trabalha. Fast mode e Ultrafast trocam custo por velocidade. O Ultra, no Codex, divide a tarefa entre subagentes em paralelo; o Ultracode, no Claude Code, faz o Claude montar um fluxo de trabalho para cada tarefa grande.
Trocar o esforço ou ligar um modo não troca o modelo. É o mesmo modelo trabalhando de outro jeito, com outro consumo.
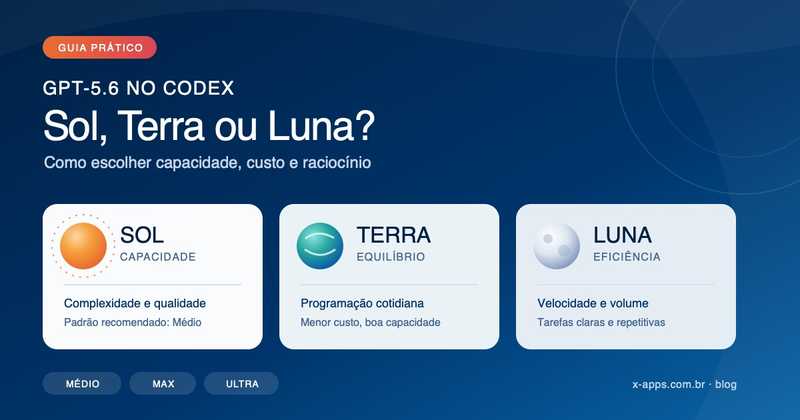
Os quatro modelos do Codex
A OpenAI posiciona os modelos atuais do Codex assim:
| Modelo | Para que serve | Observação |
|---|---|---|
| Astra | O trabalho mais exigente, de ponta a ponta, em código, aplicativos e pesquisa | O mais capaz, e mais caro que o Sol. Comece em Light |
| GPT-6.1 Sol | Trabalho complexo, repetido e longo, quando o custo pesa | Desempenho próximo do Astra por menos; janela padrão de 500 mil tokens |
| GPT-6.1 Terra | Escrita, leitura de imagens e telas, uso do computador | Rápido e eficiente; a OpenAI não o lista na extensão de IDE |
| GPT-6 Luna | Tarefas focadas e de volume: extração, classificação, resumo estruturado, código bem delimitado | O mais eficiente. Comece em High; aceita Max, mas não Ultra |
Na prática, GPT-6.1 Sol é o ponto de partida para quem programa todo dia: é o substituto oficial do GPT-5.5 e entrega perto do Astra a um custo menor. Guarde o Astra para o problema em que errar custa caro, como uma investigação de falha sem pista ou uma mudança que atravessa vários sistemas. Use o Luna quando você sabe exatamente como é um bom resultado e precisa repetir a tarefa muitas vezes, inclusive em subagentes que só leem código e resumem.
O GPT-6 Sol, da geração anterior ao 6.1, continua no Codex: é o substituto que a OpenAI indica para o GPT-5.4 e aceita Fast mode. Para quem está escolhendo hoje, o GPT-6.1 Sol é a versão recomendada.
O antigo papel do Spark, de resposta quase instantânea para ajustes pequenos, hoje se resolve de dois jeitos: um modelo menor em esforço baixo, ou um modelo maior com Fast mode ligado.
Fast mode, Ultrafast, Max e Ultra no Codex
| Controle | O que faz | Quanto custa a mais |
|---|---|---|
| Fast mode | Acelera o mesmo modelo (Astra, GPT-6.1 Sol, GPT-6.1 Terra, GPT-6 Sol e GPT-6 Luna) | Consome a franquia do plano a 2,5x a taxa padrão; créditos comprados a 2x |
| Ultrafast | Gera tokens até 8x mais rápido no Astra; também vale para o GPT-6.1 Sol | Franquia a 8x; créditos a 6x. Só no Pro de US$ 500 e em Enterprise e Edu elegíveis |
| Max | Dá mais tempo de raciocínio a uma única tarefa | Consome mais, porque o modelo raciocina por mais tempo |
| Ultra | Divide a tarefa entre subagentes em paralelo | Cada subagente trabalha por conta própria, então o consumo tende a crescer com o número de frentes |
A própria documentação da OpenAI avisa que a maior parte das tarefas não precisa de Max nem de Ultra. Max serve para o problema difícil e sequencial, em que profundidade vale mais que tempo. Ultra serve quando o trabalho se divide em partes que andam sozinhas, como migrar vários módulos independentes. Se a tarefa não se divide, o Ultra tende a aumentar o consumo sem ganho. A conta detalhada de créditos por modelo e esforço está no guia de créditos do Codex, e o que muda com o plano de US$ 500 está em ChatGPT Pro 500 e Ultrafast.
Os modelos do Claude Code
No Claude Code, os apelidos apontam para a versão mais nova de cada família quando você usa a API da Anthropic. Em outros provedores, como Amazon Bedrock e Microsoft Foundry, alguns apelidos ainda apontam para versões anteriores.
| Modelo | Apelido | Para que serve | Esforço padrão |
|---|---|---|---|
| Fable 5.2 | fable | Tarefas maiores que uma sentada: investigação de causa raiz, falha em produção, decisão de arquitetura | medium |
| Opus 5.5 | opus | Raciocínio complexo: refatoração ampla, depuração difícil | medium |
| Sonnet 5.5 | sonnet | Programação do dia a dia | medium |
| Haiku 5.5 | haiku | Tarefas simples, com rapidez e eficiência | medium |
O Fable 5.2, lançado em 9 de novembro, nunca é o modelo padrão: é preciso escolher com /model fable, e ele exige o Claude Code na versão 2.1.321 ou posterior. Dependendo do plano, o uso do Fable sai dos créditos de uso, e não da franquia da assinatura; nesse caso o seletor mostra o aviso "Requires usage credits" na linha do Fable. Na API, ele custa US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de saída, 20% abaixo do Fable 5.1. O que isso muda para quem paga por uso está na nossa análise do Fable 5.2.
Para o Opus 5.5, a Anthropic informa que o nível medium iguala ou supera o Opus 5 em high nos testes de programação. Quem migra do Opus 5 deve começar em medium, e não repetir o nível que usava antes.
Esforço, Ultracode e Fast mode no Claude Code
A documentação do Claude Code descreve cada nível assim:
- low: trocas rápidas em que você revisa cada resultado, como um rascunho ou uma renomeação.
- medium: o padrão dos modelos atuais; serve para trabalho do dia a dia com escopo claro, como implementar uma funcionalidade.
- high: quando verificar importa e os casos de borda são prováveis, como corrigir um bug numa base de código existente.
- xhigh: raciocínio mais profundo, com mais tokens.
- max: problemas difíceis que você quer que o Claude resolva sem você, como procurar vulnerabilidades. A própria Anthropic avisa que o ganho diminui e que o modelo tende a pensar demais.
O Ultracode não é um nível de esforço. É uma configuração que faz o Claude montar um fluxo de trabalho para cada tarefa grande, em qualquer nível. Ligado por claude --effort ultracode, ele já começa em xhigh. Para uma pergunta pontual que pede mais raciocínio, basta escrever ultrathink no prompt, sem mudar a sessão inteira. A curva de custo e qualidade de cada nível, medida no Opus 5, está no nosso artigo sobre os níveis de esforço do Claude.
O Fast mode deixa o modelo até 2,5x mais rápido, com o mesmo resultado e preço maior por token. Ele está disponível no Fable 5.2 e no Opus 5.5, e não existe no Sonnet nem no Haiku. Nos planos de assinatura, ele só roda com créditos de uso, fora da franquia do plano.
| Modelo em Fast mode | Entrada (US$ por milhão de tokens) | Saída (US$ por milhão de tokens) |
|---|---|---|
| Fable 5.2 | 16 | 80 |
| Opus 5.5 | 8 | 40 |
| Opus 5 e Opus 4.8 | 10 | 50 |
Quem ainda usa o Opus 4.8 com Fast mode precisa trocar até 30 de novembro de 2026, quando a Anthropic remove essa combinação e passa a recusar as chamadas.
Qual configuração escolher em cada tarefa
| Situação | No Codex | No Claude Code |
|---|---|---|
| Programação do dia a dia | GPT-6.1 Sol no esforço padrão | Sonnet 5.5 ou Opus 5.5 em medium |
| Bug numa base de código existente | GPT-6.1 Sol em High | Opus 5.5 em high |
| Falha sem pista, decisão de arquitetura | Astra, subindo o esforço se precisar | Opus 5.5 em high; Fable 5.2 se o resultado ficar aquém |
| Problema difícil e sequencial | Max no modelo escolhido | xhigh ou max |
| Tarefa grande que se divide em etapas ou frentes | Ultra | Ultracode |
| Leitura de repositório, resumo, tarefas simples | GPT-6 Luna | Haiku 5.5 |
| Ajuste pequeno com resposta rápida | Modelo menor em esforço baixo, ou Fast mode | Sonnet 5.5 em low, ou Fast mode no Opus 5.5 |
Nenhuma das duas ferramentas vence em tudo. O resultado depende mais do repositório, dos testes, das instruções que ficam salvas no projeto e da clareza do pedido do que da escolha entre OpenAI e Anthropic. Para uma equipe, o teste que vale é rodar três ou quatro tarefas reais do próprio código nas duas configurações candidatas e comparar o resultado e o consumo.
Checklist para não errar no seletor
- Configuração, script ou agente com
gpt-5.5,gpt-5.4ougpt-5.4-mini: trocar pelo substituto da primeira tabela. Comgpt-5.3-codex-spark: escolher um modelo disponível no plano. - Codex no dia a dia: GPT-6.1 Sol.
- Tarefa repetitiva com resultado bem definido: GPT-6 Luna.
- Claude Code no dia a dia: Sonnet 5.5 ou Opus 5.5 em medium.
- Tarefa longa e ambígua no Claude Code: Opus 5.5 primeiro; Fable 5.2 se o resultado ficar aquém, conferindo se o plano cobra de créditos de uso.
- Opus 4.8 com Fast mode: trocar para o Opus 5.5 até 30/11/2026.
- Max, Ultra e Ultracode só quando a tarefa pede; na maioria das vezes, não pede.
Referências
- Models, ChatGPT Learn (OpenAI), consultado em 10/11/2026
- Speed, ChatGPT Learn (OpenAI), consultado em 10/11/2026
- Model configuration, Claude Code Docs, consultado em 10/11/2026
- Speed up responses with fast mode, Claude Code Docs, consultado em 10/11/2026